
La transición desde pilotos experimentales de inteligencia artificial generativa hacia entornos de producción a escala empresarial enfrenta un obstáculo crítico en la cadena de valor de las tecnologías de la información: el tiempo de aprovisionamiento e integración física de la infraestructura (time-to-value). Tradicionalmente, la adquisición de clústeres de cómputo acelerado con GPUs de última generación, su configuración con subsistemas de red de baja latencia y la homologación del software de orquestación demandaban entre seis y doce meses de ingeniería. Durante ese lapso, la rápida obsolescencia de los modelos fundacionales y el costo de capital inmovilizado comprometían el retorno de inversión proyectado.
Para resolver este cuello de botella logístico y de integración de sistemas, Lenovo, en colaboración técnica con NVIDIA, oficializó la presentación de Lenovo AI Express. Este programa de despliegue acelerado garantiza la entrega y puesta en marcha de fábricas de IA híbridas (Hybrid AI Factories) en plazos a partir de 30 días hábiles. La solución estandariza la arquitectura de hardware en tres configuraciones escalables basadas en servidores ThinkSystem y aceleradores de la familia NVIDIA Blackwell, integrando software de grado empresarial (NVIDIA AI Enterprise, Red Hat AI Factory) y esquemas de resiliencia de datos respaldados por Veeam® Kasten.
Radiografía de Infraestructura: Configuraciones Validadas de Lenovo AI Express (2026)
| Configuración / Nivel | Plataforma de Servidor ThinkSystem | Aceleración por GPU (NVIDIA Blackwell) | Capacidad de Modelo y Rendimiento Objetivo | Escenario Operativo y Carga de Trabajo |
| Pequeña (Small) | ThinkSystem SR650a V4 (Chasis optimizado para térmicas densas) | 2× NVIDIA RTX 6000 PRO Blackwell Server Edition | Modelos de 7B a 70B parámetros; rendimiento sostenido >30 TPS | Inferencia focalizada para decenas de usuarios concurrentes; copilotos departamentales. |
| Mediana (Medium) | ThinkSystem SR675 V3 (Topología de densidad de GPU múltiple) | 8× NVIDIA RTX 6000 PRO Blackwell Server Edition | Modelos de 70B a 400B parámetros; rendimiento sostenido >30 TPS | Inferencia de alto rendimiento y ejecución de agentes de IA activos para cientos de usuarios. |
| Grande (Large) | ThinkSystem SR680a V4 (Arquitectura para centros de datos de hiperescala) | Plataforma NVIDIA HGX B300 (Interconexión NVLink de ultra ancho de banda) | Modelos a escala empresarial de hasta 1 billón (1T) de parámetros | Factoría de IA generativa completa; entrenamiento fino, RAG masivo y miles de usuarios simultáneos. |
| Capa de Software y Resiliencia | Ecosistema multiventana: NVIDIA AI Enterprise, Red Hat AI Factory, CPUs Intel/AMD | Protección de contenedores y pipelines de datos mediante Veeam® Kasten | Compatibilidad con marcos Kubernetes nativos | Garantía de soberanía del dato, respaldo ante fallos y portabilidad híbrida local-nube. |
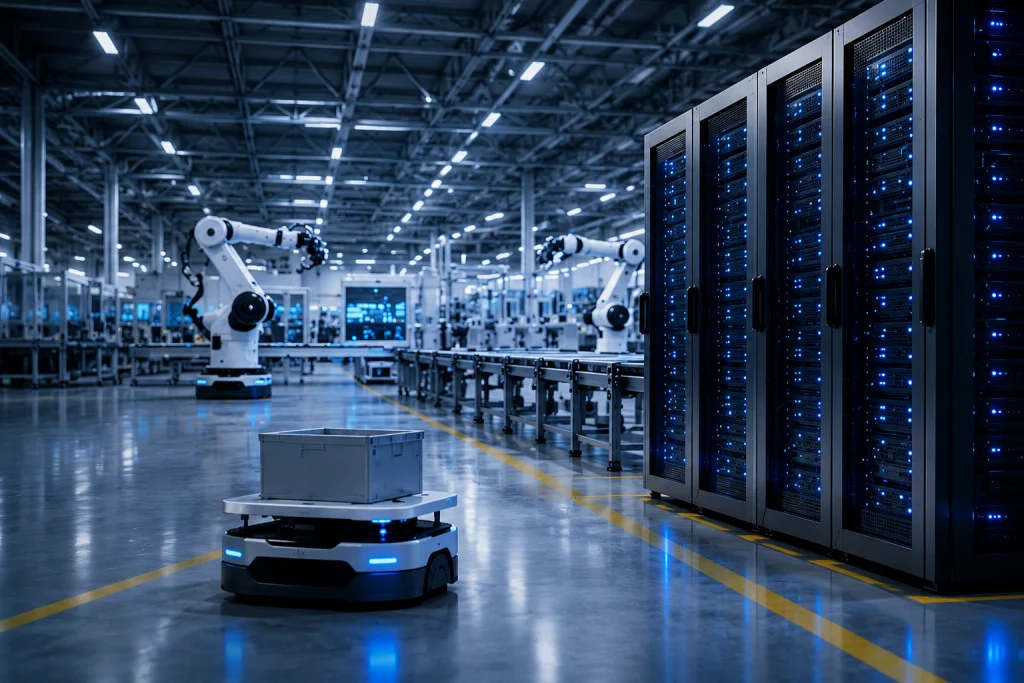
La física del aprovisionamiento: Del silicio empaquetado al retorno determinista
La estrategia técnica de Lenovo y NVIDIA aborda los desbalances financieros y termodinámicos que frenan la adopción corporativa de clústeres de IA:
[Datos Corporativos Locales] ➔ [Configuración Validada ThinkSystem / Blackwell] ➔ [Despliegue Acelerado (≤30 Días)] ➔ [Inferencia >30 TPS / Agentes Autónomos] ➔ [Retorno Económico (US$ 2.79 x US$ 1)]
- La Ecuación del Rendimiento de Inferencia (>30 TPS): En aplicaciones de agentes autónomos y asistentes en tiempo real, una velocidad de procesamiento inferior a 30 tókenes por segundo (Tokens Per Second o TPS) introduce una latencia perceptible que degrada la interacción humano-máquina y rompe la ejecución de flujos de trabajo concatenados. Al calibrar el ancho de banda de la memoria de las GPUs RTX 6000 PRO y HGX B300 con la interconexión PCI Express de los servidores ThinkSystem, Lenovo asegura que la tasa de generación de respuestas supere el umbral ergonómico y operativo necesario para flujos críticos.
- Mitigación del Sobredimensionamiento de Capital (Capex): Los datos de la Guía de estrategias para CIO de Lenovo 2026 indican que el 93% de las compañías proyecta un retorno positivo promedio de US$ 2.79 por cada dólar invertido en IA a escala. No obstante, adquirir clústeres sobredimensionados antes de identificar los casos de uso reales drena el capital de trabajo. La modularidad en tres niveles permite a las empresas iniciar con dos aceleradores para casos locales y expandirse hacia clústeres HGX a medida que el volumen de inferencia y la base de usuarios crecen.
- Resiliencia de Cadenas de Entrenamiento con Veeam Kasten: A diferencia de las bases de datos relacionales, una fábrica de IA procesa tuberías (pipelines) continuas compuestas por modelos, conjuntos de pesos (weights), bases de vectores y microservicios en contenedores. Integrar Veeam Kasten asegura la inmutabilidad de los datos ante ataques de ransomware dirigidos y permite recuperar estados específicos del modelo tras fallos de corrupción de memoria o envenenamiento de datos.
Implicaciones para la modernización de centros de cómputo en América Latina
Para el mercado corporativo centroamericano y del Cono Sur, la promesa de entrega a partir de 30 días hábiles altera la dinámica de adquisición de tecnología avanzada. Las organizaciones financieras, de telecomunicaciones y de manufactura en la región han dependido de nubes públicas en el extranjero para sus pruebas de concepto, incurriendo en altos costos de transferencia de datos (data egress) y enfrentando barreras normativas de soberanía sobre información de clientes.
La disponibilidad de configuraciones preempaquetadas a través de la red de canales Lenovo 360, respaldadas por el servicio predictivo Premier Support Plus, facilita que las corporaciones construyan sus propios entornos de cómputo híbrido dentro de sus centros de datos locales o instalaciones de colocación, conservando la propiedad de sus datos y mitigando riesgos de fuga de secretos industriales.
“El despliegue de inteligencia artificial ha superado la fase de la retórica teórica para convertirse en un problema de logística de ingeniería y eficiencia energética. Cuando los proveedores reducen el plazo de entrega de meses a semanas y entregan sistemas precalificados bajo estándares de rendimiento verificables, el retorno de inversión deja de ser una proyección incierta para consolidarse como una métrica predecible en el balance general”, concluyen los análisis sobre infraestructura de centros de datos y computación acelerada.
Con la articulación entre los sistemas ThinkSystem y la arquitectura NVIDIA Blackwell, Lenovo AI Express establece una base operativa donde la velocidad de aprovisionamiento, la certidumbre técnica y la contención de riesgos determinan qué organizaciones liderarán la era de la IA híbrida en la región.